Fariz Galang Nusantara Putra Setiawan
Program Studi Magister Teknik Mesin
Fakultas Teknik
Universitas Indonesia, Depok, Jawa Barat
Assalamualaikum, teman-teman. Di blog ini saya mencoba untuk menguraikan proses algoritma Artificial Neural Network (ANN) secara detail. Saya akan mengupas bagaimana proses kalkulasi yang terjadi dalam algoritma ANN, cara algoritma ANN dalam mengubah variabel-variabelnya, serta rumus-rumus matematis seperti apa yang digunakannya.
A. Arsitektur Artificial Neural Network (ANN)
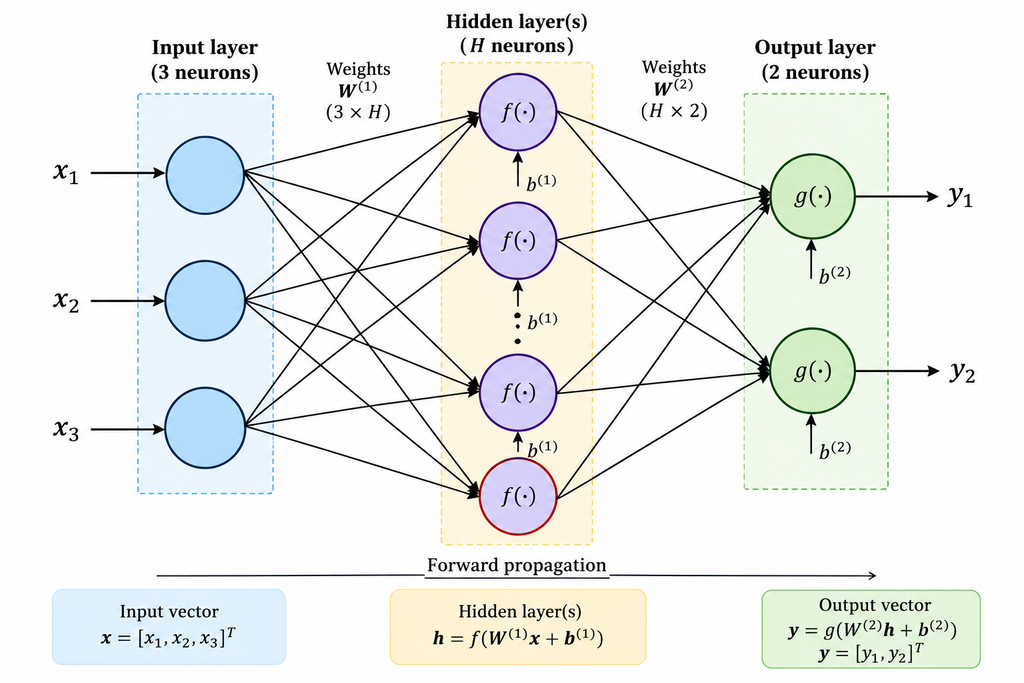
Jika digambarkan, ANN akan terlihat seperti Gambar 1. ANN terdiri dari input, output, dan hidden layer yang masing-masing memiliki sejumlah neuron. Jumlah dari hidden layer dan neuron yang terdapat di dalamnya merupakan variabel bebas yang diatur oleh si pembuat algoritma, dan variabel ini dinamakan sebagai “hyperparameter.”
Hyperparameter tidak hanya sebatas jumlah dari hidden layer dan neuron, namun lebih dari itu, rumus optimizer, activation function, jumlah training, loss function, dan lain-lain, yang nanti akan dibahas lebih detail, juga merupakan hyperparameter dari ANN.
B. Perhitungan Matematis ANN
Pada dasarnya, Setiap neuron hanya menyelesaikan persamaan aljabar sederhana. Rumus umum pada setiap neuron dapat dilihat pada persamaan berikut:
dengan :
: nilai input ke-.
: bobot dari input ke- menuju hidden neuron ke-.
: bias pada hidden neuron ke-
: fungsi aktivasi hidden layer.
: output dari hidden neuron ke-.
Agar persamaan tersebut dapat terasa lebih mudah dicerna, mari pahami contoh berikut:
Sebuah ANN memiliki 2 input, 1 hidden layer dengan 3 neuron, dan 1 output. Maka, setiap neuron pada hidden layer akan memiliki persamaan:
Dapat dilihat bahwa untuk setiap input terdapat nilai bobot yang membersamainya, dan untuk setiap neuron memiliki satu nilai bias. Kedua nilai inilah yang nantinya akan disesuaikan oleh algoritma backpropagation sehingga idapat nilai bobot dan bias yang sesuai.
Persamaan tersebut merupakan contoh sederhana dari ANN. Namun, persamaan yang digunakan dapat lebih kompleks, seperti persamaan kuadratik, tergantung besar data dan kebutuhan.
C. Scaling data/Normalisasi
Dalam melakukan training ANN, diperlukan sebuah normalisasi data khususnya pada dua atau lebih input yang memiliki range berbeda. Misalnya input pertama memiliki range 10-50, sedangkan input kedua memiliki range 200-400. Normalisasi dilakukan agar mempercepat training dan memberikan data prediksi yang lebih akurat. Rumus normalisasi yang banyak digunakan adalah sebagai berikut:
Dimana,
x : data yang dinormalisasi,
x_min : data paling rendah
x_max : data paling tinggi
Dengan melakukan normalisasi, maka range kedua input akan sama, sehingga mempermudah training. Namun, perlu diperhatikan bahwa output yang dihasilkan akan berupa data normalisasi juga, sehingga perlu dikembalikan ke rentang aslinya.
D. Activation Function
Ketika melakukan training, diperlukan adanya activation function. hal ini dikarenakan bentuk dari data training biasanya tidak linear, dan jika tidak ada activation function, maka penjumlahan persamaan aljabar dari setiap hidden neuron akan menghasilkan persamaan linear saja. Activation function digunakan pada setiap nilai yang telah dikalkulasi oleh setiap hidden neuron, sebelum nilai tersebut diberikan ke hidden layer setelahnya.
Bentuk ari activation function ada cukup banyak. Beberapa yang paling sering digunakan adalah Rectified Linear Unit (ReLU), Sigmoid, dan tanh. Berikut adalah bentuknya dalam bahasa matematika:
Relu :
Sigmoid :
tanh :
E. Loss Function
Nilai prediksi ANN tentu memiliki kesalahan pada mulanya. Error dari prediksi dikalkulasi menggunakan loss function. Umumnya loss function yang digunakan adalah Mean Squared Error (MSE) atau Mean Absolute Error (MAE). Dalam bentuk matematis dapat diekspresikan sebagai berikut:
MSE :
MAE :
Dimana,
N : Jumlah data
i : urutan data
Yi : Nilai aktual pada data ke-i
Yi^ : Nilai prediksi pada data ke-i
F. Backpropagation
Back propagation merupakan algoritma kunci dibalik sistem training ANN. Algoritma ini mampu untuk melihat bobot dan bias ke-berapa pada neuron ke-berapa yang akan diubah sehingga nilai prediksi selanjutnya akan lebih baik. Nilai bobot dan bias akan diubah melalui persamaan berikut:
dan
dimana nilai η merupakan learning rate yang juga merupakan salah satu dari hyperparameter. Dapat ilihat pada persamaan tersebut bahwa terdapat differential error terhadap bobot/bias. Untuk mendapatkan nilai tersebut, dilakukan sebuah identitas differential bernama chain rule, sebagai berikut:
Persamaan loss function diturunkan terhadap y, kemudian dikalikan turunan y terhadap h, dan dikalikan kembali dengan turunan h terhadap w. Dari identitas ini, didapatkan nilai differential loss function terhadap bobot/bias.
Algoritma ini dilakukan kepada setiap nilai bobot/bias pada setiap neuron sehingga nilai prediksi dapat akurat. Kualitas training juga dapat ditentukan dari nilai learning ratenya, di mana jika learning rate terlalu rendah akan menyebabkan training menjadi sangat lama. Sebaliknya, jika learning rate terlalu tinggi, maka training dapat overshoot dan sulit mencapai stabilitas.
ANN melakukan keseluruhan perhitungan ini dalam waktu 5-10 ms. iterasi berulang ini dinamakan sebagai epoch. Melalui serangkaian perhitungan ini pula, banyak eksperimen maupun simulasi, yang memakan waktu lama, dipangkas sedemikian rupa. Sehingga eksperimen/simulasi yang dilakukan hanya sebagai pelengkap data training. Dan untuk memprediksi nilai eksperimen terbaru, dapat dilakukan hanya dengan memberi input kedalam ANN yang telah di-training.
G. Overfitting dan Underfitting
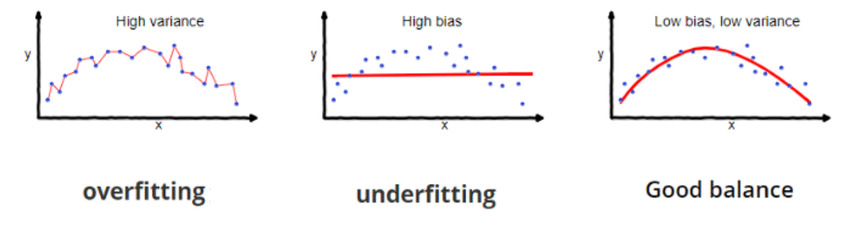
ANN, apabila nilai hyperparameter tidak di-tuning dengan baik, maka akan cenderung untuk overfitting atau underfitting. Overfitting adalah keadaan di mana ANN memprediksi data training dengan sangat baik, namun melenceng jauh jika diberikan data validasi. Hal ini dapat disebabkan oleh banyak hal, misalnya terlalu banyaknya neuron dan hidden layer. Sebaliknya, underfitting adalah keadaan di mana ANN tidak dapat memprediksi data dengan akurat, baik untuk data training maupun validasi. Hal ini dapat disebabkan oleh kurangnya neuron, maupun jumlah training yang kurang cukup.
Untuk dapat dengan mudah memahami, silahakan perhatikan gambar 2 berikut.
Alhamdulillah, dengan penjelasan overfitting dan underfitting maka blog ini telah selesai. Semoga blog ini dapat memberi wawasan kepada teman-teman semua. Terimakasih.
